
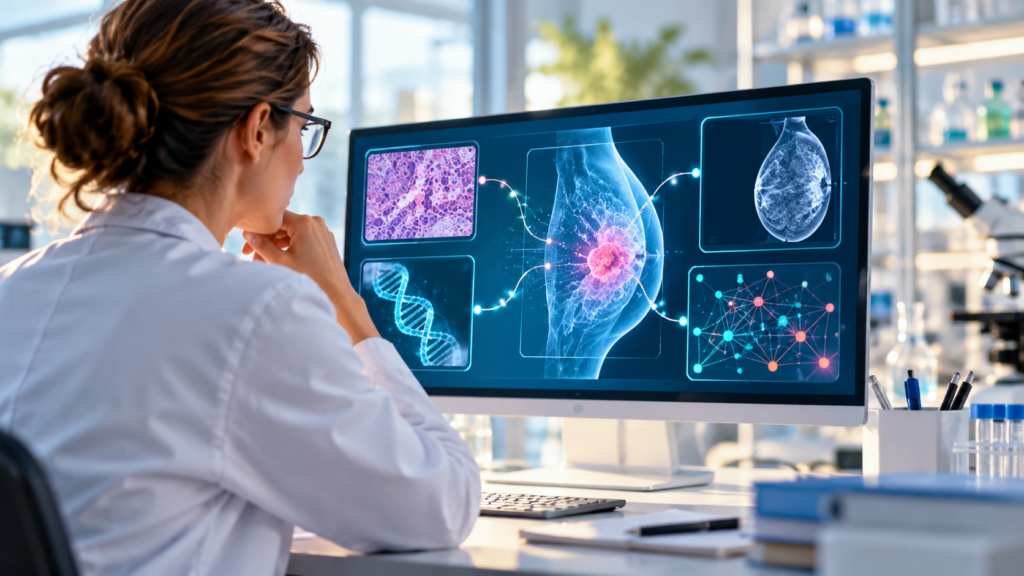

La investigación del cáncer de mama está incorporando una nueva forma de aprovechar la información sanitaria. Los historiales clínicos, las pruebas radiológicas, los análisis moleculares y los datos genéticos pueden aportar una visión mucho más completa de la enfermedad cuando se estudian conjuntamente. Esa posibilidad está detrás de diferentes proyectos de espacios de datos que buscan facilitar la colaboración entre organizaciones sanitarias y aplicar herramientas de inteligencia artificial al estudio de los tumores.
Coincidiendo con el Día Mundial contra el Cáncer de Mama, el Centro de Referencia de la Economía del Dato (CRED) ha presentado este 19 de octubre un caso de uso que reúne diversas iniciativas orientadas a conectar información sanitaria que habitualmente permanece repartida entre distintos centros y sistemas. El objetivo es convertir esos datos en conocimiento útil para comprender la evolución de la enfermedad, identificar factores de riesgo y desarrollar estrategias de atención más ajustadas a las características de cada paciente.
Uno de los principales desafíos que plantea este enfoque es que la información de una misma persona puede encontrarse distribuida entre hospitales, consultas y servicios sanitarios diferentes. Los resultados de una prueba de imagen, los tratamientos recibidos y los análisis posteriores no siempre están organizados de una manera que permita estudiarlos conjuntamente.
Para abordar esta dificultad, el Espacio de Datos de Sanidad Privada (EDSP) trabaja con modelos de resúmenes clínicos estructurados, conocidos como Patient Summary, que permiten reunir información relevante, como diagnósticos, antecedentes, tratamientos, alergias y resultados analíticos. Esta organización busca facilitar tanto la continuidad asistencial como el aprovechamiento de los datos en proyectos de investigación.
Conectar imágenes, información genética e historiales clínicos
La información que proporciona un tumor va mucho más allá de su localización o tamaño. Las imágenes médicas, los biomarcadores y las alteraciones genéticas ayudan a describir sus características, mientras que los historiales clínicos permiten conocer cómo ha evolucionado la enfermedad y qué tratamientos ha recibido cada paciente.
Evidenze Data Space trabaja precisamente en la integración de datos clínicos, radiológicos y moleculares. La combinación de estas fuentes permite estudiar relaciones que pueden pasar inadvertidas cuando cada tipo de información se analiza por separado. De esta manera, los investigadores pueden disponer de una representación más completa de la enfermedad y explorar patrones que contribuyan al desarrollo de la medicina de precisión.
Otra de las iniciativas recogidas por el CRED es SHARE, siglas de SpanisH cAncer data spacE, orientada a integrar información clínica, genética, molecular y de seguimiento procedente de distintas organizaciones. Entre sus aplicaciones se encuentra la posibilidad de estudiar perfiles de riesgo y desarrollar modelos que ayuden a estimar la probabilidad de recaída o la respuesta a diferentes tratamientos.
El interés de este trabajo reside en aprovechar la experiencia acumulada en la atención de numerosos pacientes. Cuando la información está organizada de forma compatible, los investigadores pueden estudiar grupos más amplios, analizar la evolución de la enfermedad y buscar relaciones entre características clínicas y resultados sanitarios.
Inteligencia artificial sin trasladar todos los datos a un único lugar
Compartir conocimiento sanitario plantea también una cuestión fundamental: cómo colaborar entre instituciones sin comprometer la privacidad de los pacientes.
En este ámbito trabaja Acuratio Health, mediante la creación de grupos de datos compatibles entre diferentes organizaciones y el desarrollo de inteligencia artificial federada. Este sistema permite entrenar modelos en cada institución, utilizando los datos que permanecen bajo su control, y compartir determinados parámetros del aprendizaje para construir herramientas comunes.
El procedimiento ofrece una vía para aprovechar información distribuida entre hospitales y entidades sanitarias sin necesidad de reunir todos los historiales individuales en una única base de datos. La normalización de la información mediante modelos comunes, como OMOP CDM, facilita que conjuntos de datos de diferentes procedencias puedan analizarse de forma coordinada.
El CRED también identifica el trabajo de EDS2.eus, un centro demostrador que explora la combinación de información sanitaria y sociosanitaria para desarrollar modelos de seguimiento y atención personalizada. Esta perspectiva amplía el estudio de la enfermedad hacia aspectos como la monitorización de la salud, la calidad de vida y la coordinación de los cuidados.
Las distintas iniciativas abordan partes complementarias de un mismo desafío: que la información recogida durante la atención sanitaria pueda contribuir, con las garantías necesarias, a investigar mejor el cáncer de mama. Su desarrollo abre posibilidades para perfeccionar los modelos predictivos y estudiar las necesidades de seguimiento de las pacientes, aunque la utilidad clínica de cada aplicación deberá evaluarse con los procedimientos científicos correspondientes.
La conexión entre datos clínicos, imágenes e información genética se perfila así como una herramienta de creciente interés para la investigación oncológica, al permitir estudiar la enfermedad desde perspectivas que hasta ahora no siempre podían combinarse de forma sencilla.

